解析・測定:2026年10月14日/対象:OCRDataProvider 3.4.02.20と手元にインストール済みのOCRモデル
Galaxyの写真から日本語をコピーできる機能は、どのようなニューラルネットワークで動いているのでしょうか。SamsungのOCR用APKを調べ、日本語データを分解し、実際の重みを使うWindows版を作成しました。さらにmanga-ocr、EasyOCR、PaddleOCR、Baidu Unlimited-OCRと同じ画像を読み、速度と文字の誤りを比較しました。
見えてきたのは、巨大な言語モデルだけがOCRの答えではないということです。今回取り出したSamsungの主な検出・日本語認識経路は、合計約237万パラメーター相当の小さな構成でした。文字の場所を探すネットワークと、文字列を読むネットワークを分け、画像の扱い方にも工夫が入っています。
性能表のSamsungは、APKから取り出した実モデルをONNX Runtimeで動かすWindows移植版です。Galaxy実機の純正OCR SDKを測定したものではありません。重みの出典は照合済みですが、画像の切り出し、長い行の扱い、辞書・言語モデル、縦書き処理などには移植側の制限があります。
1.まず結果を読む:小さなモデルと大きなモデル、それぞれの強み
今回の横書き5ページ・206文字では、PaddleOCR v6 mediumとUnlimited-OCRが文字誤り0でした。Samsung移植版は5文字の誤りが残ったものの、CPUだけでページの呼び出し時間中央値が約111 ms。EasyOCRはGPUで約52 msでした。小規模な合成画像による診断ですが、精度、速度、使う計算資源の違いがはっきり現れました。
| ページ全体を読むOCR | 実行環境 | 文字誤り率 CER | 完全一致ページ | 呼び出し時間中央値 |
|---|---|---|---|---|
| Samsung APK移植版 | CPU | 5/206=2.43% | 1/5 | 111.24 ms |
| EasyOCR 1.7.2 | GPU | 11/206=5.34% | 2/5 | 52.47 ms |
| PaddleOCR/PP-OCRv6 medium | CPU | 0/206=0.00% | 5/5 | 3474.90 ms |
| Baidu Unlimited-OCR | GPU | 0/206=0.00% | 5/5 | 1161.95 ms |
同じCPU/GPU条件での演算効率比較ではありません。CPUはCore i9-13900K、GPUはRTX 3080 Ti 12 GiB。PaddleはWindows上の既存環境でMKLDNNを無効にしています。モデル初期ロードは除外し、画像読込と各API内の前後処理を含みます。細かな測定方法は第10節を参照してください。
もう一つの発見は、文字が読めたことと、文章として正しく取り出せたことが別だという点です。縦書きでは列の順序だけで大きな誤りになり、白紙では画像にない文を出すモデルもありました。単一の点数で順位を付けるより、処理経路と失敗例を見た方が、実際の使い方に結び付きます。
2.OCRの基礎:「何と書いてあるか」の前に「どこにあるか」
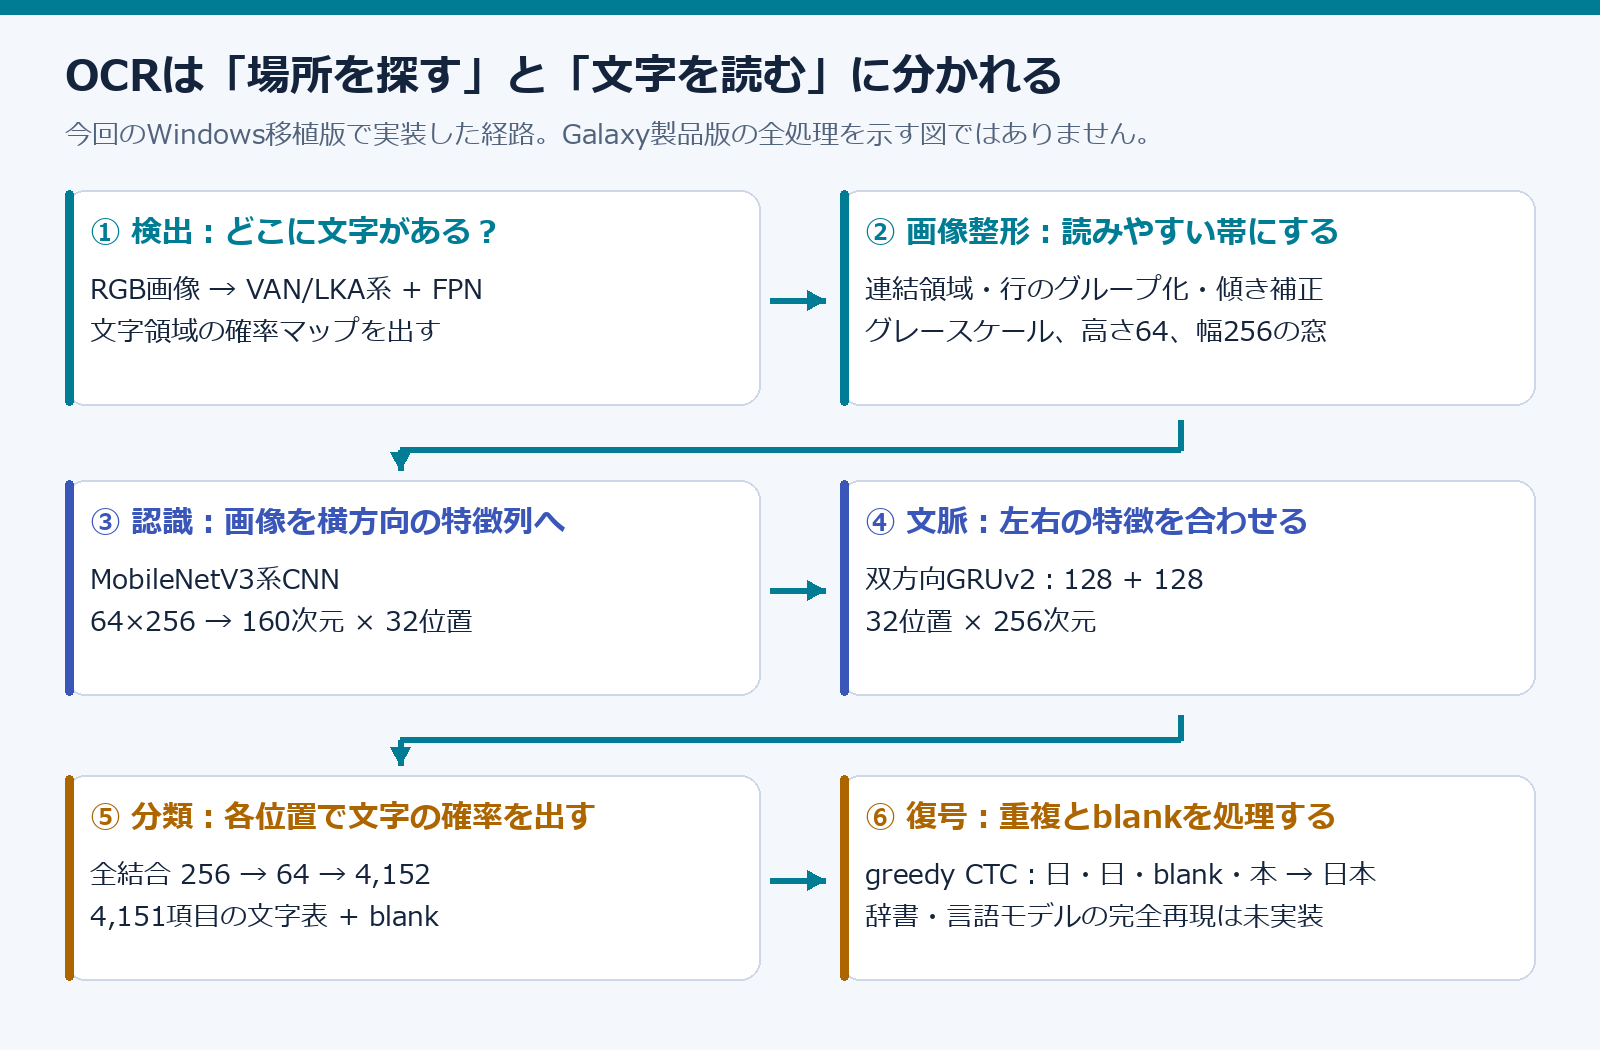
OCRはOptical Character Recognitionの略で、画像に写った文字をコンピューターが扱える文字列へ変換する技術です。写真には文字だけでなく、余白、背景、枠線、イラスト、影などもあります。まず文字の場所を見つけ、読みやすい形に切り出してから認識するのが、今回のSamsung移植版やEasyOCR、PaddleOCRに共通する基本的な考え方です。
検出では「ここに文字がある」という領域を求めます。認識では、その領域の画像を「東京都」などの文字列にします。さらに複数の行を文章にするには、どの行から読むかという読み順も必要です。文書をMarkdownや表にするモデルでは、見出し、段組み、表などの構造も扱います。
「マスク」は何を表すのか
検出器が出すマスクは、画像の各位置について文字領域らしさを0〜1で表した確率マップです。しきい値以上の部分をつなげ、四角形や行領域として取り出します。この段階では「日」か「目」かは分かりません。文字の形を個別に切り抜くマスクとも異なります。
今回のWindows版には文字領域マスク、行領域、字形に近い二値マスクなどの出力があります。ただし、字形用のglyph_maskは領域内に適応的なしきい値処理を施したものです。Samsungの別のニューラルネットワークが一文字ずつ字形を分割した結果ではありません。この区別を付けると、背景が文字として残ったときに、検出器と二値化のどちらを直すべきか判断しやすくなります。
ニューラルネットワークと後処理は、一緒に精度を作る
同じ認識モデルでも、文字の上下が欠ける、背景と文字が反転する、行が斜めのまま渡される、といった入力の差で結果が変わります。モデルの大きさだけでOCRの使い勝手は決まりません。今回、Samsungでは行画像を直接渡すよりも、ページから検出・傾き補正して渡す方が良い結果になった例がありました。
3.解析の出発点:APKにエンジン本体が全部入っているとは限らない
対象はパッケージ名com.samsung.android.sdk.ocr、表示名OCRDataProvider、バージョン3.4.02.20のAPKです。APKはAndroidアプリの配布ファイルで、ZIPとして中を見ると、プログラムのDEX、設定、画像、学習済みモデルなどを確認できます。
このAPKには19言語分のOCR用DAT、ブロック解析用のba.dat、モアレ検出用TFLiteなどがありました。一方、APK内にはネイティブ共有ライブラリの.soがありません。DEXにはJNIを介してSamsung固有の認識ライブラリを呼ぶコードがあり、APKだけで独立して動くOCRアプリとは構成が違います。
そこで、手元のSC-52B用ファームウェアから古いSTRIDE系の資源を取り出し、さらに公開されている別世代のSamsungファームウェアダンプからlibSDKRecognitionOCR.spenocr.samsung.soなどを調べました。これにより、Java側のAPIだけでは見えなかったモデル読込やリカレント層の計算を追う手掛かりが得られました。
| 証拠 | 今回の役割 | 言える範囲 |
|---|---|---|
| OCRDataProvider 3.4.02.20 APK | 日本語DAT、検出DAT、DEXの取得元 | 今回使ったモデルの出典を直接確認できる |
| SC-52BのAndroid 12ファームウェア | 旧STRIDE資源、Gallery 13.1.04.3の調査 | 旧世代の構成。現行APKとの同一性は別問題 |
| A53系Android 13の公開ダンプ | ARM64ネイティブOCRライブラリの解析 | 計算式の裏付け。2026年APKと同じ版とは確認できていない |
| Samsung Researchの公式説明 | 製品の背景、言語判別・認識・言語モデルの位置付け | 公開説明。個々のバイナリの層構造を確定する証拠とは分ける |
Samsung Researchは、One UIのOCRに言語の自動判別、認識用ニューラルネットワーク、言語モデルが関わり、端末内で動作すると説明しています。今回の言語別DATや補助モデルは、その説明と対応する実装上の手掛かりです。ただし、公開研究のネットワークを、そのまま対象APKのネットワークと同一視することはできません。Samsung Researchの製品技術説明
調査中には旧STRIDEのTFLite、ネイティブ側のCRNN・MDLSTM関連の痕跡なども見つかりました。しかし今回の日本語DATから直接取り出してWindowsで使った認識器は、以下で説明するCNN+双方向GRUv2です。「Samsung OCRはMDLSTMだ」と一括してまとめると、世代や経路の違いを落としてしまいます。
4.11.2 MBの日本語DATを開く:辞書、重み、復号資源が同居していた
ocr_ja_JP.datは11,176,127バイト、十進表記で約11.2 MBです。拡張子のDATは用途を保証する形式名ではありません。実際に先頭のヘッダーと領域表を読むと、7個の部品を格納する容器になっていました。
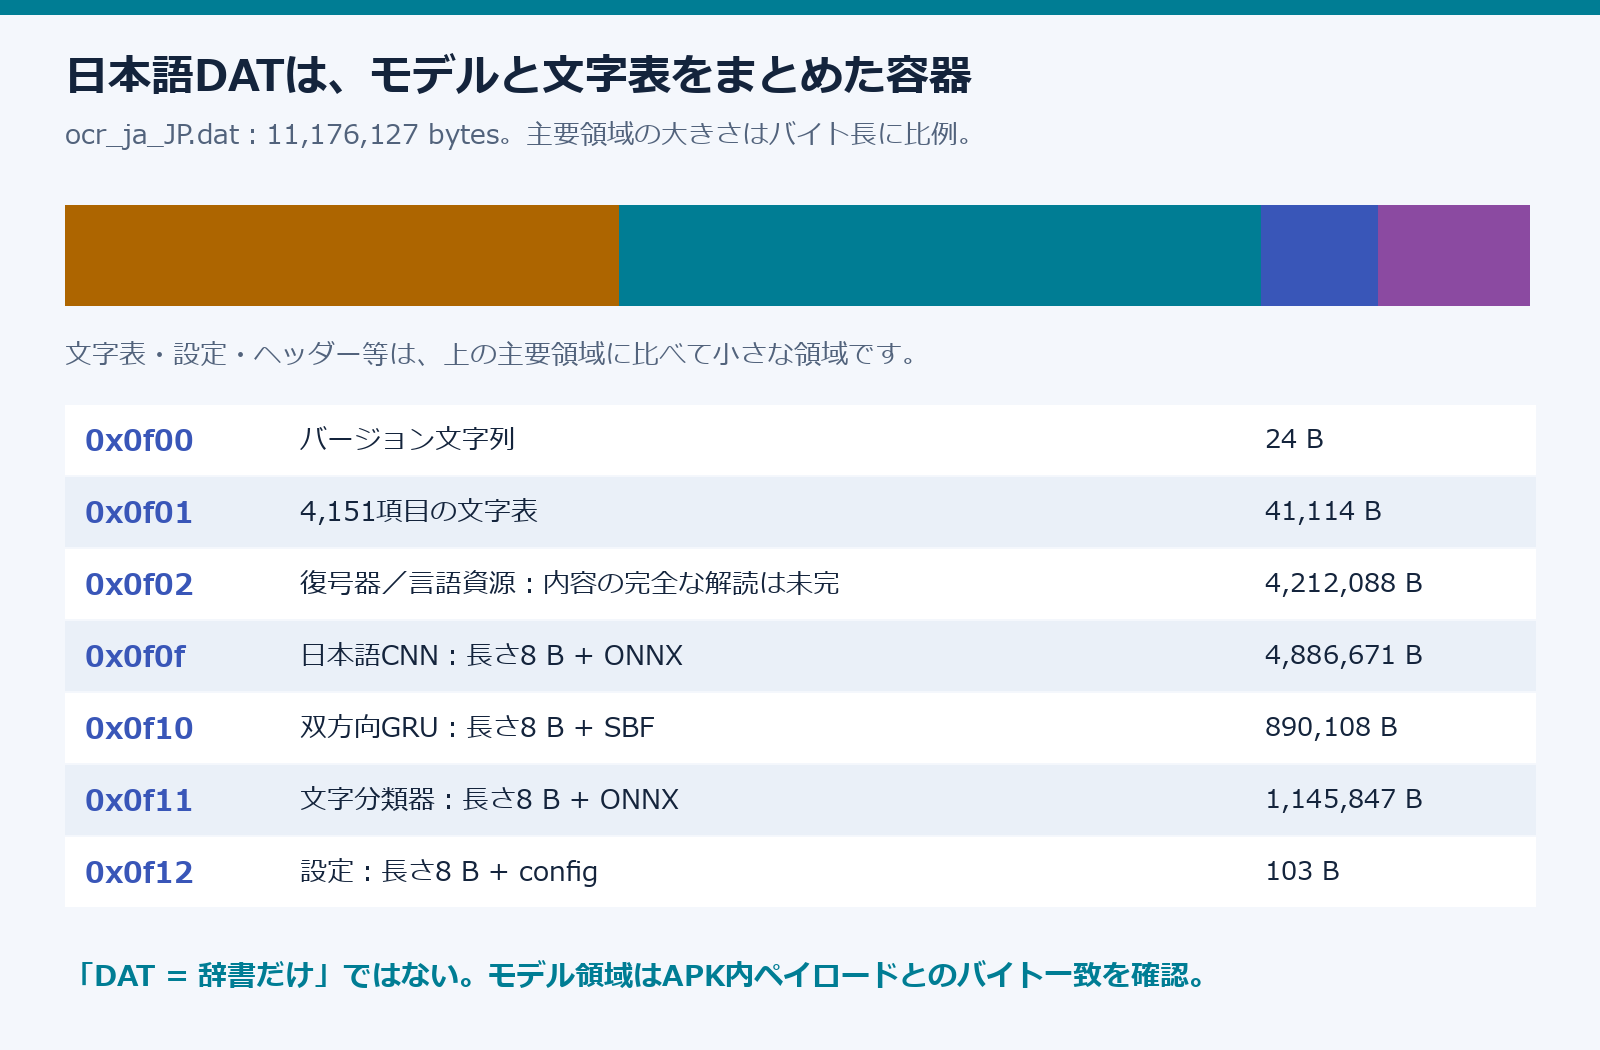
重要なのは、約11.2 MBのうち約4.89 MBがCNNのONNX、約0.89 MBがリカレント層のSBF、約1.15 MBが文字分類器のONNXだったことです。日本語の文字表は4,151項目。DATには日本語を読むための数値の重みが実際に入っており、「文字辞書だけ」という仮説は否定できます。
一方、約4.21 MBの領域は完全には解読できていません。以前の解析ではAM_SCALE、LM_SCALE、beam幅に関係する文字列が見つかっています。認識の確率と言語モデルの確率を組み合わせる復号資源と考えられますが、辞書の内容、言語モデルの形式、全処理の復元までは到達していません。
専門家向け:ヘッダーと領域表の読み方
外側はlittle-endianで、先頭2バイトが0xf000、続いて8バイトの長さ、8バイトの部品数です。領域表はオフセット18から始まり、1項目18バイトで、typeがuint16、offsetとlengthがuint64です。モデル領域の一部には、さらに8バイトの長さが付いています。
import struct

magic, container_length, count = struct.unpack_from('<HQQ', raw, 0)
assert magic == 0xf000
for i in range(count):
    kind, offset, length = struct.unpack_from('<HQQ', raw, 18 + i * 18)
    assert offset + length <= len(raw)
    payload = raw[offset:offset + length]
    # kindごとに、文字表・ONNX・SBFなどの内部形式を読む
ここに示したのは外側の容器を読む最小例です。ヘッダーの長さ値の意味、内部の長さフィールド、モデル形式をそれぞれ検証してから切り出します。「ONNXらしい文字列がある」という検索だけでは、モデルの正しい先頭と終端は決まりません。
「本当にSamsungのモデルか」を照合する
抽出後のファイルは、APKのZIPエントリーとDAT内ペイロードへ戻ってバイト単位で比較しました。日本語CNN、SBFのGRU、文字分類器、検出器のONNXはいずれも一致しています。別のOCRへ置き換えたり、今回の入力に合わせて再学習したりした結果ではありません。ただし、GRUをSBFからONNXへ変換する際には、後述するゲート順序とテンソル配置の変換が必要です。
追跡用:主要ファイルのSHA-256
バージョン名だけでなく、以下のハッシュで今回の解析対象を区別しています。
OCRDataProvider APK / 170,666,499 B
f407032938717a9e9b4abe0b132dcca8c965d3a135dac9c93f12a76c15159714

ocr_ja_JP.dat / 11,176,127 B
e40c01fe98027c05fb57441f595b0ca29802343db1f6d598442f711453ee63c5

ba_5.onnx / 2,662,328 B
fb6a0b24b6785f640fd5a78c46bc423fb9387e86c8cb6fe1cac986423415a8c7

cnn_original.onnx / 4,886,663 B
cad9613e5c14161efa09e32654e61674e62e95be8db3315d25ad3fbd20b4934d

recurrent_original.sbf / 890,100 B
3a088b3d94a1d2acaa6a6c68603a6c01e67c75695f2e7cf68610d26925b41bdf

mlp.onnx / 1,145,839 B
65549bc9a276c141d3badde4e08eabb5fc5e83b374d544f36590fa525aaba3dc
5.文字領域検出:大きな畳み込みで周囲を見るLKAとFPN
検出用ba.datから取り出したba_5.onnxは、RGBの1024×1024画像を受け取り、1チャンネルの1024×1024確率マップを出します。グラフにはbackbone/van、spatial_gating_unit、backbone/fpnという名前が残り、接続とカーネルを調べるとVAN/Large Kernel Attention系の構成でした。
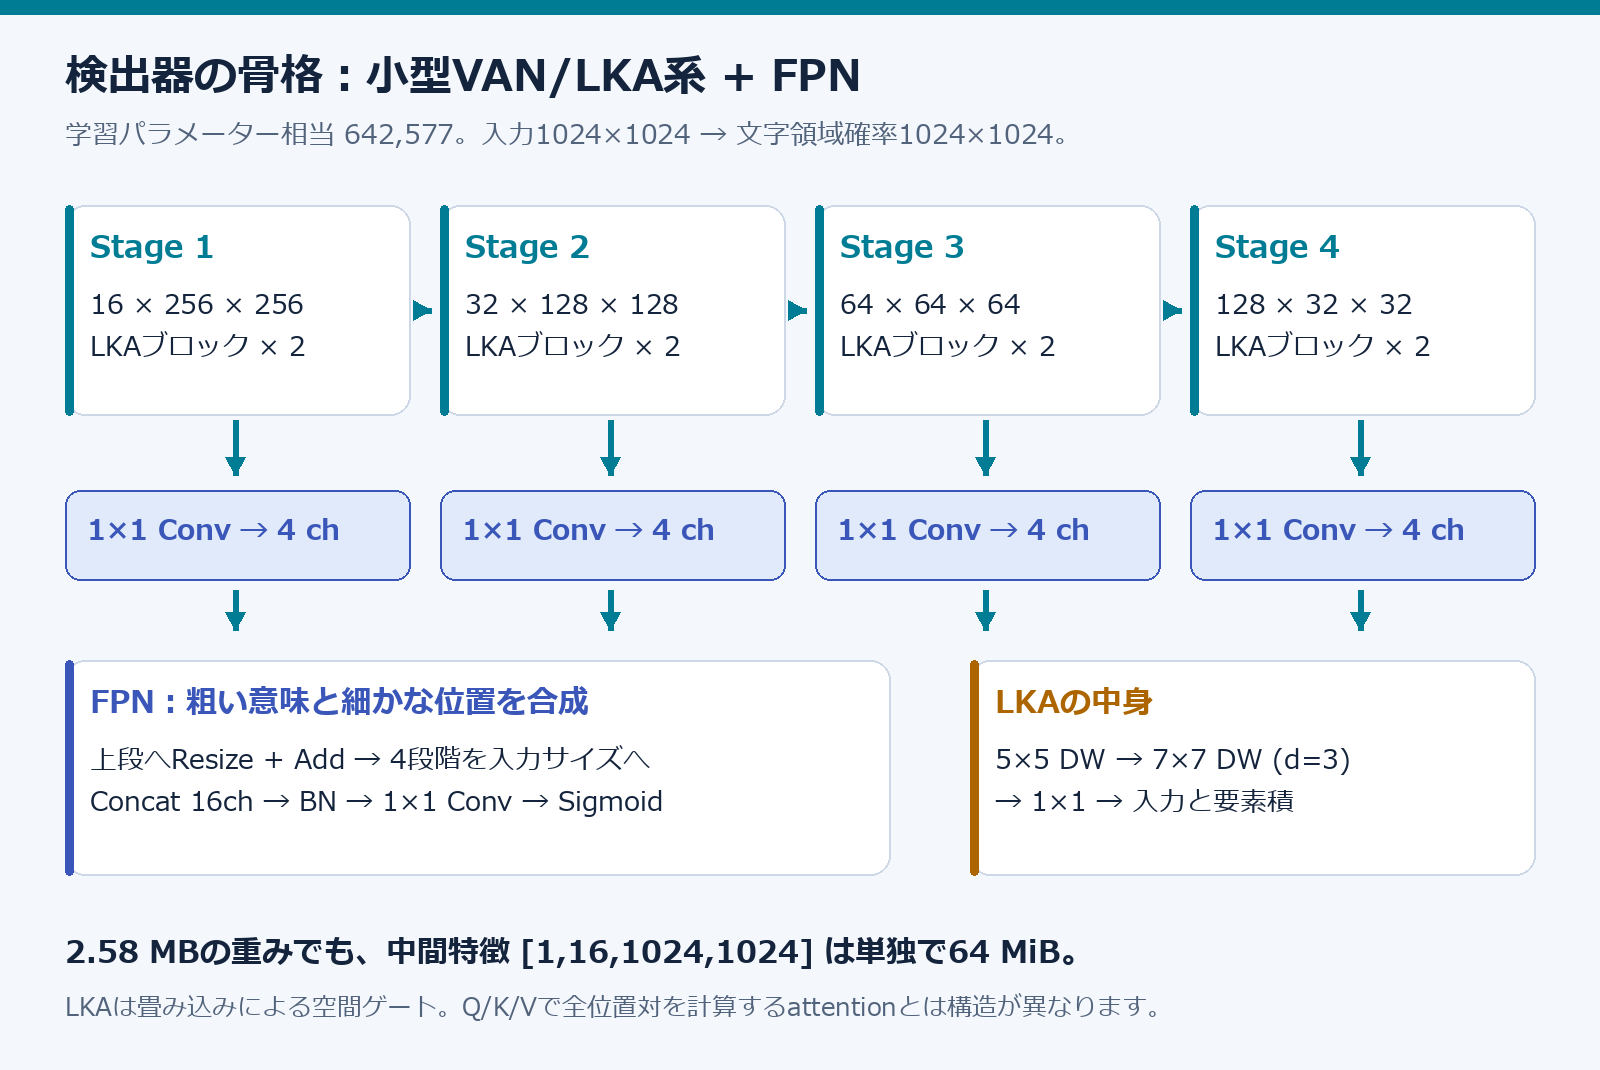
画像は4段階で小さくなります。チャンネル×高さ×幅は、16×256×256、32×128×128、64×64×64、128×32×32です。各段階に2個、合計8個のLKAブロックがあります。前半は細かい位置を残し、後半では広い範囲の特徴を扱う構成です。
LKAのattentionは、畳み込みで作る空間ゲート
LKAの主要部分は、5×5のDepthwise畳み込み、dilation 3の7×7 Depthwise畳み込み、1×1畳み込み、元の特徴との要素ごとの乗算です。Depthwiseはチャンネルごとに空間を処理する方式で、通常の畳み込みより演算を減らせます。dilationは参照する位置の間隔を広げ、少ない重みで広い範囲を見る仕組みです。
ここでのattentionは、画像の全位置同士のQ/K/Vを計算するTransformerの自己注意とは構造が異なります。周囲から作ったゲートで特徴を強めたり弱めたりするため、広い文脈を畳み込みで取り込めます。公開VAN実装との対応を根拠にした構造上の同定であり、モデルの学習履歴までは分かりません。VANの公式実装
FPNは、縮小して得た情報を高解像度へ戻す
文字の場所を決めるには、深い層で得た意味のある特徴と、浅い層に残る細かな位置の両方が必要です。FPNは複数の解像度を組み合わせます。今回のグラフでは各段階を4チャンネルへ射影し、上位からResizeとAddで合成します。4段階を最終的に1024×1024へそろえて連結し、16チャンネルの特徴から1×1畳み込みとSigmoidで文字領域確率を作ります。
保存float32値は645,011個、BNの平均・分散と定数を除いた学習パラメーター相当は642,577個です。活性化にはReLU6相当のClipがあり、公開VANの構成を全くそのまま使ったとは言えません。
6.日本語CNN:高さを1にし、文字の横方向の順序を残す
日本語認識の入口は、グレースケールの64×256画像です。CNNは画像の局所的な線や角、字形の組み合わせを特徴へ変えます。今回のCNNにはMobileNetV3-Largeの先頭13個のbottleneckと対応する、展開チャンネル数、出力チャンネル数、カーネル、SEの配置がありました。これはネットワーク構造の一致から判断した系列名です。MobileNetV3原論文
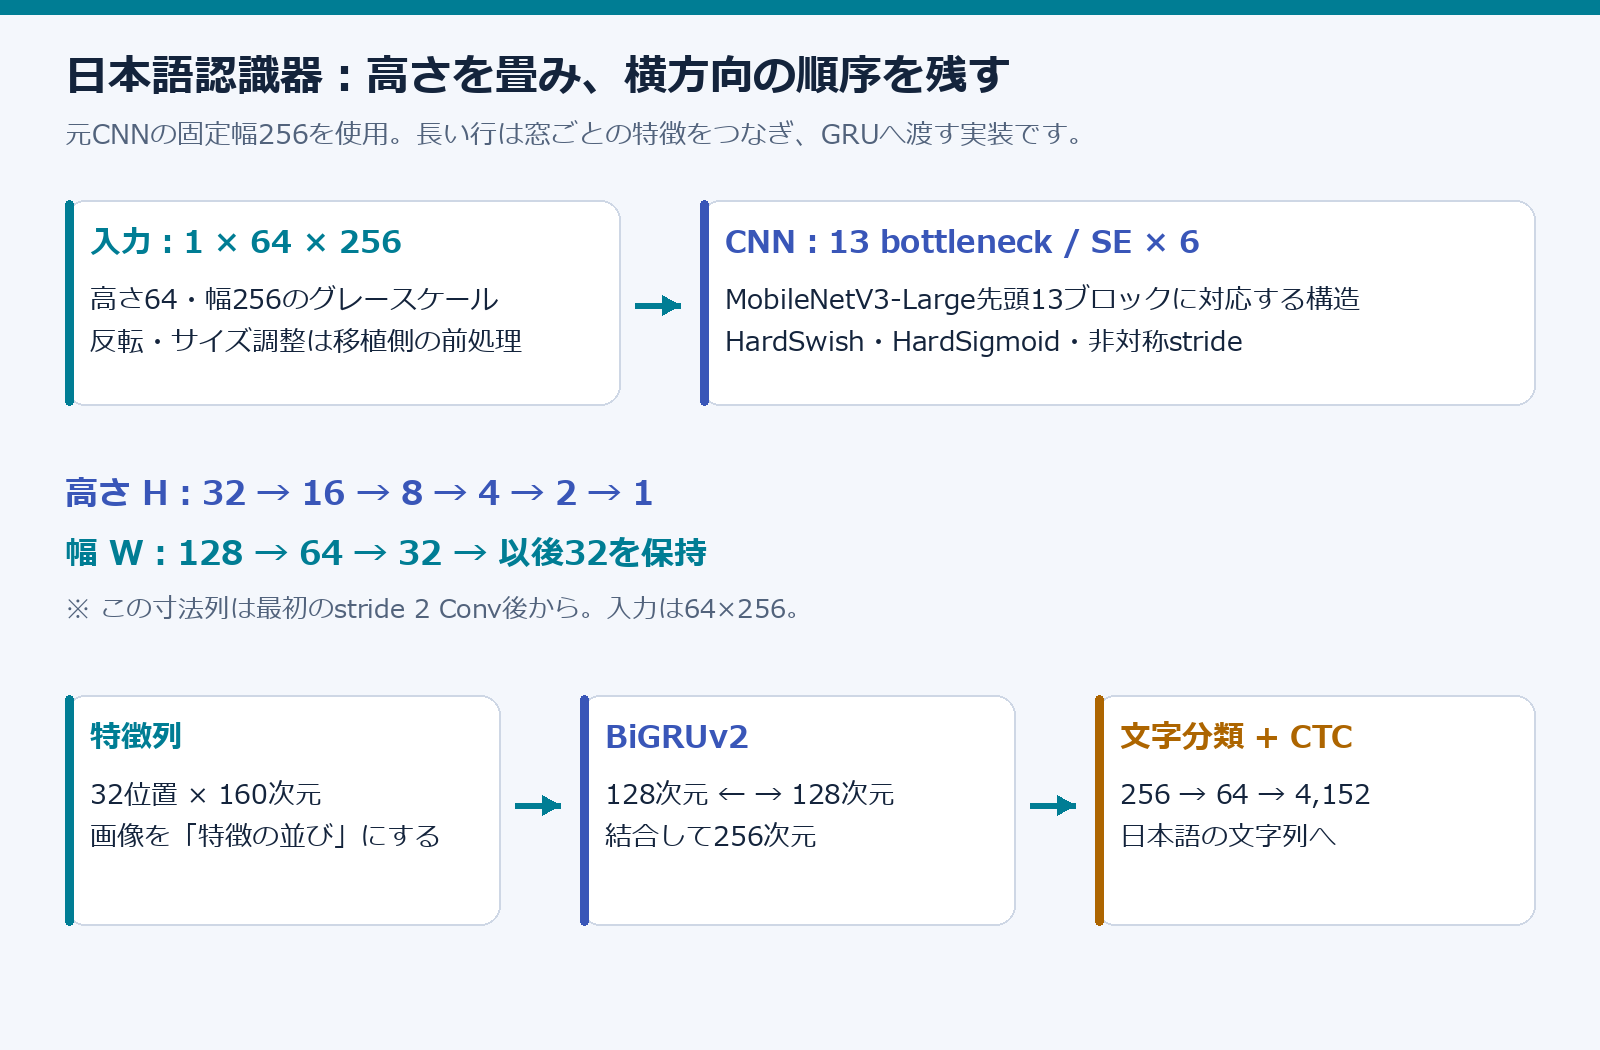
画像分類用ネットワークでは、縦横を同じように縮めることが一般的です。OCRでは、横方向の並びを失いすぎると文字を並べにくくなります。今回の7・11・13番目のブロックはstrideが(2,1)で、高さだけを半分にします。最初のConv後から高さは32→16→8→4→2→1、幅は128→64→32まで縮んだ後、32を保ちます。最後は160次元の特徴が32位置に並ぶ形になります。
SEはチャンネルの強弱を調整する
6個のブロックにはSE、Squeeze-and-Excitationがあります。入力ウィンドウ全体の平均からチャンネルの重みを計算し、特徴に乗算する仕組みです。HardSigmoidやHardSwishも演算列と定数から確認できました。これらは軽量なネットワークで非線形な変換を行う要素です。
HardSigmoid(x) = clip(x + 3, 0, 6) / 6
HardSwish(x)   = x * HardSigmoid(x)
SEの平均には幅方向も含まれます。そのため、ONNXの入力幅を可変に書き換えて、長い行を一度に渡せるようにしても、固定幅256を何回か処理する場合と同じ結果にはなりません。窓の中で平均する範囲が変わるからです。移植時に形状だけを変更して動作したことと、元の計算を再現したことは区別が必要です。
現在のWindows版では元の固定幅CNNを256画素ずつ実行し、末尾をゼロで補い、有効な特徴位置をつないでいます。これは移植側で選んだ処理であり、Galaxyネイティブ版が長い行を同じ方法で分割することを証明したものではありません。
専門家向け:13ブロックの形状一覧
| # | 展開C | DW kernel | stride H×W | SE縮小次元 | 出力 C×H×W |
|---|---|---|---|---|---|
| 1 | 16 | 3×3 | 1×1 | — | 16×32×128 |
| 2 | 64 | 3×3 | 2×2 | — | 24×16×64 |
| 3 | 72 | 3×3 | 1×1 | — | 24×16×64 |
| 4 | 72 | 5×5 | 2×2 | 24 | 40×8×32 |
| 5 | 120 | 5×5 | 1×1 | 32 | 40×8×32 |
| 6 | 120 | 5×5 | 1×1 | 32 | 40×8×32 |
| 7 | 240 | 3×3 | 2×1 | — | 80×4×32 |
| 8 | 200 | 3×3 | 1×1 | — | 80×4×32 |
| 9 | 184 | 3×3 | 1×1 | — | 80×4×32 |
| 10 | 184 | 3×3 | 1×1 | — | 80×4×32 |
| 11 | 480 | 3×3 | 2×1 | 120 | 112×2×32 |
| 12 | 672 | 3×3 | 1×1 | 168 | 112×2×32 |
| 13 | 672 | 5×5 | 2×1 | 168 | 160×1×32 |
1〜6はReLU、7〜13はHardSwish系。分類用MobileNetV3の末尾までを含むモデルではありません。
7.双方向GRU:左右から文脈を見る小さなリカレント層
CNNの特徴だけでは、似た字形や不鮮明な文字を区別しにくい場合があります。次のGRUは特徴の列を順に読み、隠れ状態という情報を次の位置へ受け渡します。双方向なので左から右、右から左の二つの経路があり、両方を合わせて位置ごとの特徴を作ります。
日本語DATのSBF 2.1には、160次元入力、片方向128ユニット、1層の双方向GRUv2がありました。左右を結合した出力は256次元です。これはGRU自身による特徴列の文脈処理です。DATに残る別の辞書・言語モデルによる復号とは区別してください。
重みを移すだけでは動かない:ゲート順序とリセット位置
GRUには、過去をどの程度引き継ぐかを決めるupdateゲート、過去をどの程度リセットするかを決めるresetゲート、新しい候補状態があります。名前が同じGRUでも、重みの並びや数式の細部が異なる実装があります。今回はSBFの並びがreset→update→candidate、ONNXがupdate→reset→candidateでした。
専門家向け:復元したGRUv2の式とONNX変換
r[t] = sigmoid(Wr*x[t] + br + Rr*h[t-1])
z[t] = sigmoid(Wz*x[t] + bz + Rz*h[t-1])
n[t] = tanh(Wn*x[t] + bn + r[t] * (Rn*h[t-1] + bRn))
h[t] = z[t]*h[t-1] + (1-z[t])*n[t]
候補状態のrecurrent biasをresetゲートの内側に置くため、ONNXではlinear_before_reset=1を使用しました。各ゲートの入力重みは128×160、リカレント重みは128×128です。ONNX GRUの演算子仕様
さらに各方向128個、合計256個の初期状態がSBFに保存され、すべて非ゼロでした。ゼロ初期化に置き換えると計算が変わります。保存されていたことは確認できますが、学習で得た初期状態かどうかは値だけからは断定できません。
変換したONNXと同じ式をNumPyで計算した比較では、単一ステップの最大絶対差が約1.79×10⁻⁶、47位置では約5.27×10⁻⁶でした。これは変換した二つの計算経路の一致を支える結果です。現行Galaxyのネイティブ中間テンソルとの一致を測定したものではありません。数式の調査に使ったネイティブライブラリは別世代です。
8.4,152個の出力から文字列へ:CTCを理解する
GRUの次は、256→64→4,152の全結合ネットワークです。途中にTanh、最後にSoftmaxがあり、各位置で文字の候補確率を出します。日本語文字表が4,151項目、分類出力が4,152なので、追加の1個をblankとして扱うCTC形式の復号を実装しています。
CTCは、画像をあらかじめ一文字ずつ分割しなくても、位置ごとの確率列から文字列を取り出せる方式です。同じ文字が隣の位置にも出てよく、何も出さないblankもあります。Windows版では各位置で最も確率が高い出力を選び、連続した同じ出力をまとめ、blankを取り除くgreedy復号を使います。
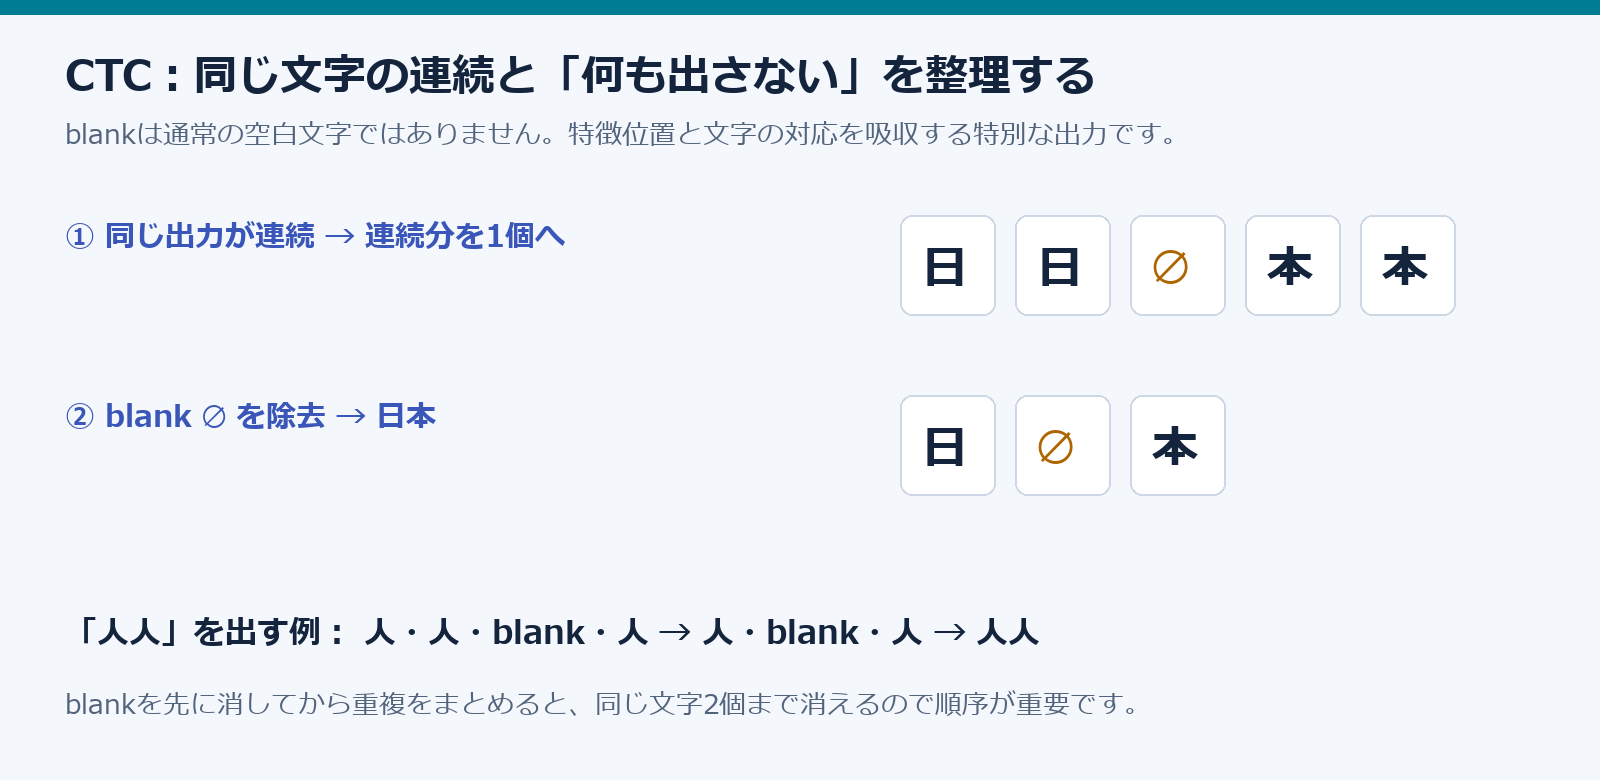
def greedy_ctc(indices, charset, blank=4151):
    out, previous = [], None
    for index in indices:
        if index != previous and index != blank:
            out.append(charset[index])
        previous = index
    return ''.join(out)
この例は単純な復号の考え方です。純正SDKが使う可能性のあるbeam探索は、複数の文字列候補を追い、言語資源の点数も合わせて選べます。今回のWindows版は約4.21 MBの復号資源を完全には使えていません。句読点、曖昧な字形、固有名詞などで純正SDKとの差が残る可能性があります。
9.比較した5種類は、何が違うのか
同じOCRでも、モデルが受け持つ範囲は違います。Samsung、今回のEasyOCRとPaddleの認識器は、特徴位置ごとの分類をCTC系で文字列にします。manga-ocrは画像から文字トークンを順番に生成し、Unlimited-OCRは文書構造も含めて生成する視覚言語モデルです。ページ検出器の有無も、比較条件に関わります。
| 対象 | 今回のローカル実体で確認した構成 | 規模の目安 |
|---|---|---|
| Samsung移植版 | VAN/LKA系+FPN検出、MobileNetV3系CNN+1層BiGRUv2+MLP認識 | 検出0.643M+認識1.723M |
| manga-ocr 0.1.15 | ViT/DeiT系12層encoder+BERT系2層decoder、cross-attention | 111,005,952パラメーター |
| EasyOCR 1.7.2 | CRAFT/VGG16系検出、VGG+2層BiLSTM+CTC分類の日本語g2認識 | 検出20,770,466+認識4,325,671 |
| PaddleOCR 3.7.0 | PP-OCRv6 medium、LCNetV4、RepLKFPN、LightSVTR、CTCLabelDecode | 検出15,488,353+認識19,115,158の保存値 |
| Baidu Unlimited-OCR | SAM ViT-B系+CLIP ViT-L系画像経路、MoE decoder 12層/hidden1280 | BF16保存値3,336,106,240 |
Mは100万。SamsungのGRU数には保存初期状態を含み、Paddleの保存値にはBNの状態も含みます。全行が同じ定義の「学習パラメーター数」ではありません。規模を示す表として読んでください。UnlimitedはMoEなので、保存された全expertが各トークンで全部使われるわけではありません。
manga-ocr:日本語のまとまりを読む生成型認識器
ローカルのモデルはkha-white/manga-ocr-baseです。224×224、patch 16、hidden 768、12層の画像encoderと、hidden 768、2層、語彙6,144のBERT系decoderでした。「ViT+GPT-2」と固定ラベルで書くと今回の実体とは合いません。
manga-ocrは吹き出しなどの切り出した画像を読む用途が中心で、文字領域検出器そのものは含みません。公式READMEは縦書き・横書き、複数行などを想定し、文字がない画像でも文章を生成する場合があると説明しています。今回の比較では実際の漫画作品を使った網羅的な採点はしていません。manga-ocr公式README
PaddleOCR:インストール済みモデルはv6 mediumだった
古いスクリプトに書かれた製品名を信じず、保存推論グラフとconfigを調べました。今回動かしたのはPP-OCRv6_medium_det/recで、認識の出力クラスは18,710、CTCLabelDecodeです。PaddleOCRのパッケージバージョンと、選んだモデルの世代は別の情報です。PaddlePaddle公式モデル説明
Unlimited-OCR:画像と言語を合わせる文書パーサー
保存configでは、decoderは12層、hidden 1280、10 heads、64個のrouted expert、2個のshared expert、top-k 6でした。画像経路にはSAM ViT-B系とCLIP ViT-L系があり、単なる文字分類器より広い文書解析を受け持ちます。今回の推論はGPU/BF16で、プロンプトは<image>document parsing.です。
公式が提案するR-SWAは、参照する画像の情報を保ちつつ最近のテキストへ注意範囲を絞り、長い出力でdecoderのキャッシュが増え続ける問題を抑える考え方です。モデル重みや画像特徴まで含むメモリー全体が一定になること、どんな長文も正確に読めることを意味するわけではありません。今回の実測は短い単ページと行画像であり、長文PDFや40ページ連続転写の性能は測定していません。Unlimited OCR Works原論文/公式実装と推論設定
EasyOCR:検出と認識を組み合わせやすい構成
今回の日本語g2認識器はVGG特徴抽出と2層BiLSTM、分類器の構成でした。検出器はCRAFTです。行画像を渡した比較でも標準のreadtextを使ったため、時間に検出処理が含まれます。「行画像だから純粋な認識器単体の速度」として扱わないようにしています。EasyOCR公式認識モデル実装
10.比較の設計:何を入力し、何を数えたか
測定用に、標準ゴシック、黒背景、7度の傾き、英数字混在、小さい薄い文字という5種類の横書きページを作成しました。正解は合計206文字です。同じ内容を11枚の行画像としても渡し、ページ全体を読む経路と認識対象が切り出されている経路を分けました。
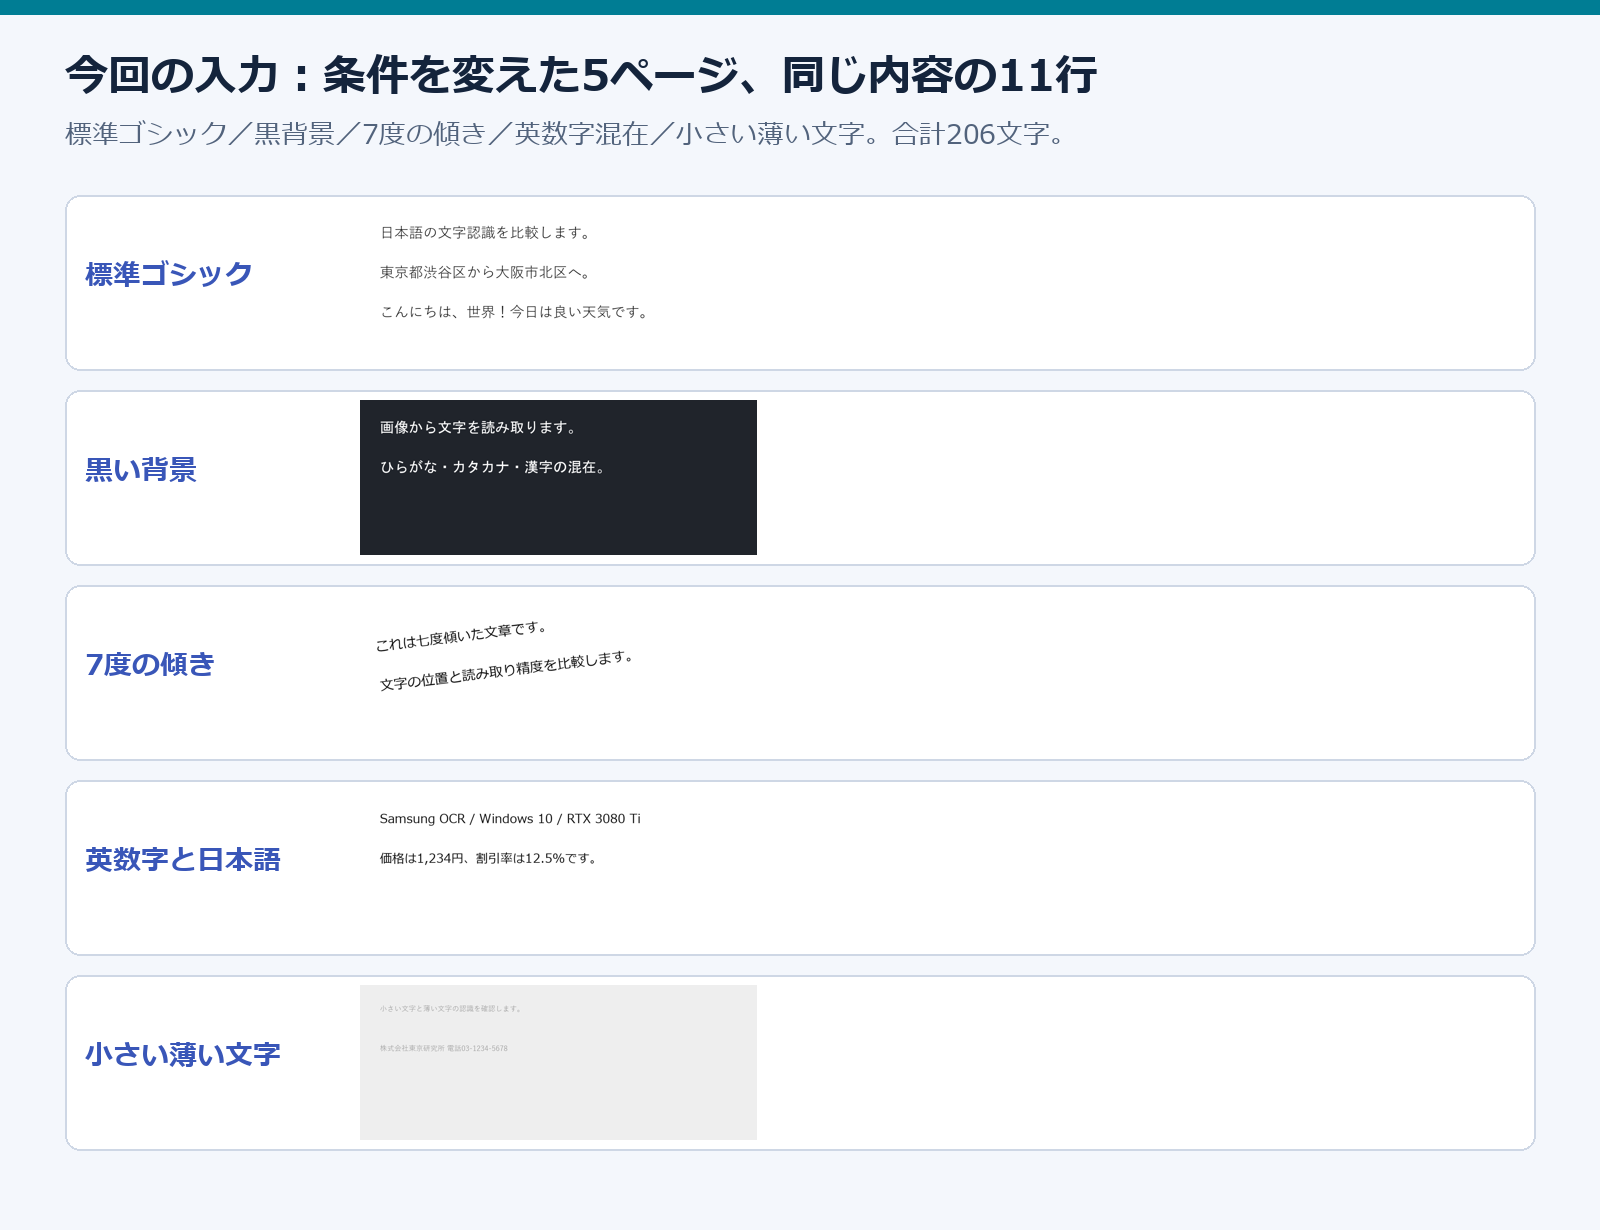
追加で22文字・2列の縦書き1ページ、白紙1ページも用意しました。既存の日本語画像と漫画画像も実行しましたが、見切れや正解との対応を完全に再構成していないため、精度集計から外しています。合計22画像ファイルの中にはページと切り出し画像の両方があり、22種類の独立した文書という意味ではありません。
正解テキストは採点にだけ使いました。OCRのプロンプトに答えを与えたり、正解に合わせてモデルを学習・選択したりしていません。ただし、少量の制御された合成画像です。写真、漫画のルビ、手書き、古い印刷物、多段組みを代表する一般ベンチマークではありません。
CERは「間違えた文字の割合」。句読点も数える
CER = (置換の数 + 削除の数 + 挿入の数) / 正解文字数採点前にUnicode NFKCで全角・半角などをそろえ、空白・改行を除去しました。句読点の違いは残しています。Markdownの画像参照とネイティブの構造タグは文字採点から外し、生出力は別途保存しました。CERは挿入が多ければ100%を超えることがある指標で、「正解率」の単純な裏返しとして表すと誤解を生みます。
完全一致は、この正規化後に全文が一致した画像数です。例えば句読点だけの誤りが各ページに散っていれば、CERは小さくても完全一致ページ数は少なくなります。字形と読み順の問題を同じ文字列距離だけで評価する限界もあるため、縦書きでは出力そのものを確認しました。
実行環境と計時の範囲
| 項目 | 今回の条件 |
|---|---|
| CPU/GPU | Intel Core i9-13900K/NVIDIA RTX 3080 Ti 12 GiB、CPUスレッド設定4 |
| Samsung | ONNX Runtime 1.31.0、CPU、元の固定幅CNN、greedy CTC |
| manga-ocr | 0.1.15、FP32、CPUとCUDA |
| EasyOCR | 1.7.2、CUDA、日本語+英語、行画像もreadtextで検出込み |
| Paddle | paddleocr 3.7.0/paddlepaddle 3.3.1、CPU、v6 medium、MKLDNN無効。文書方向・歪み・行方向の補助処理は無効 |
| Unlimited | CUDA/BF16、gundam、base_size 1024、image_size 640、crop_mode=True、max_length 2048 |
| 共通のGPUスタック | PyTorch 2.6.0+cu124、Transformers 4.57.6 |
主表は各画像を3回呼び出し、その中央値を取り、さらに画像間の中央値を表示しています。時間はモデル初期ロードを除き、API呼び出し内の画像読込・前後処理を含みます。Samsung、EasyOCR、Paddle、Unlimitedには事前の試行があり、manga-ocrはモデル初期化後に各画像を3回実行しています。manga-ocrのページ直接入力という補助診断だけは各1回です。GPUは呼び出し前後にCUDA同期を入れました。
UnlimitedのAPIは結果ファイルの保存まで含むため、その時間も含まれます。max_lengthは画像・プロンプトの入力を含む総系列長です。採点対象外の既存日本語画像では入力だけで2,317トークンとなり上限を超えたため、そこだけ4,096へ増やして再実行しました。主表の設定と混ぜていません。
この比較で分かるのは、手元の環境と設定で使ったときの待ち時間です。CPUとGPUが違い、前後処理も異なるため、アーキテクチャ単体の演算効率、端末NPU上の速度、消費電力の比較にはなりません。
11.ページ全体の結果:Samsungは小さく速く、句読点に差が残る
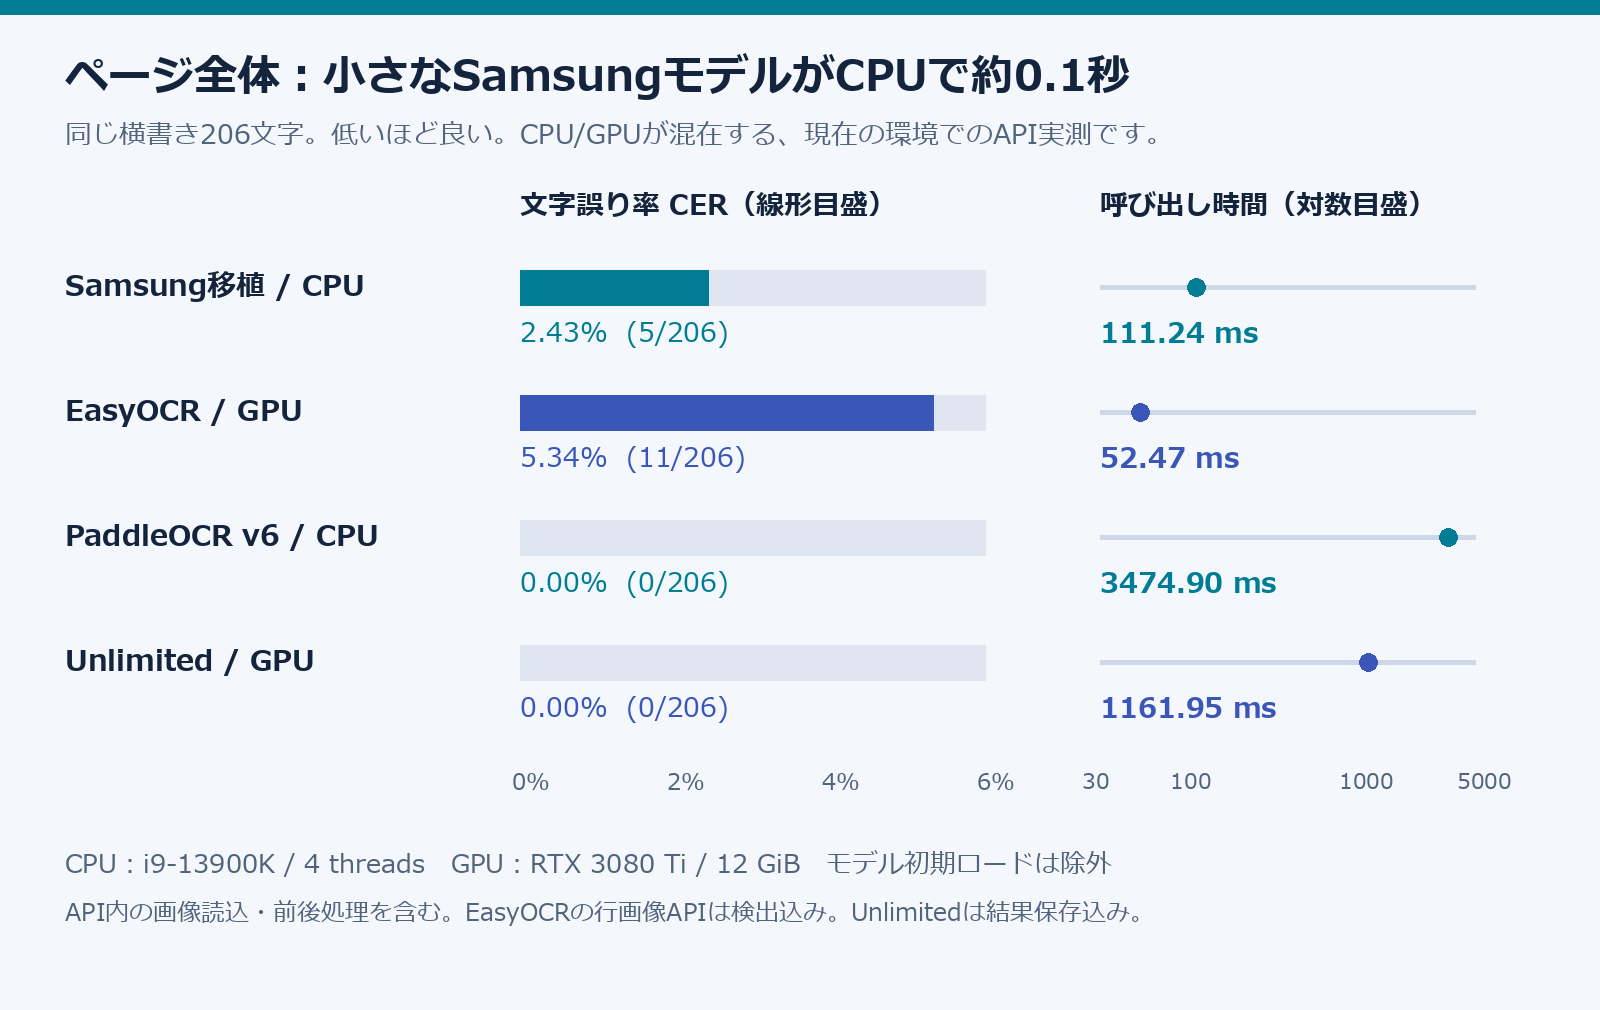
Samsungの5誤りの内訳は、読点「、」からカンマ「,」への置換が2件、中黒「・」から「•」が2件、「文章」から「文革」が1件でした。最後は字形の認識誤りですが、前の4件は記号の表記差です。文字列を検索する用途と、元の文章を忠実に復元する用途では、同じ誤りでも影響が違います。
SamsungのDAT設定には句読点変換に関係する項目があり、別の言語資源も残っています。今回のgreedy復号と移植側の後処理だけでは、純正SDKの記号処理を完全には再現できていません。観測した差を「Samsung製品は読点が苦手」とそのまま一般化しないことが必要です。
PaddleとUnlimitedは、この206文字では誤り0でした。一方、Paddleは約3.47秒、Unlimitedは約1.16秒でした。PaddleのCPUバックエンド設定を変えたり、GPUを使ったりすれば速度は変わる可能性があります。今回は、その最適化後の性能を測ったわけではありません。
manga-ocrはページ検出器を持たないため、この主表には入れていません。参考として横書きページをそのまま1画像として渡すとCERは71.36%でした。これは入力範囲の違いを示す補助診断であり、ページ検出を持つOCRと同条件で能力を順位付けする数値ではありません。
12.行画像の結果:入力整形を含めて比較しないと見誤る
| 行画像を渡すOCR | CER | 完全一致行 | 中央値 |
|---|---|---|---|
| Samsung移植/CPU | 18/206=8.74% | 5/11 | 8.79 ms |
| manga-ocr/CPU | 52/206=25.24% | 5/11 | 207.62 ms |
| manga-ocr/GPU | 52/206=25.24% | 5/11 | 66.50 ms |
| EasyOCR/GPU、検出込み | 23/206=11.17% | 3/11 | 16.01 ms |
| PaddleOCR v6 medium/CPU | 0/206=0.00% | 11/11 | 228.33 ms |
| Unlimited/GPU | 0/206=0.00% | 11/11 | 547.21 ms |
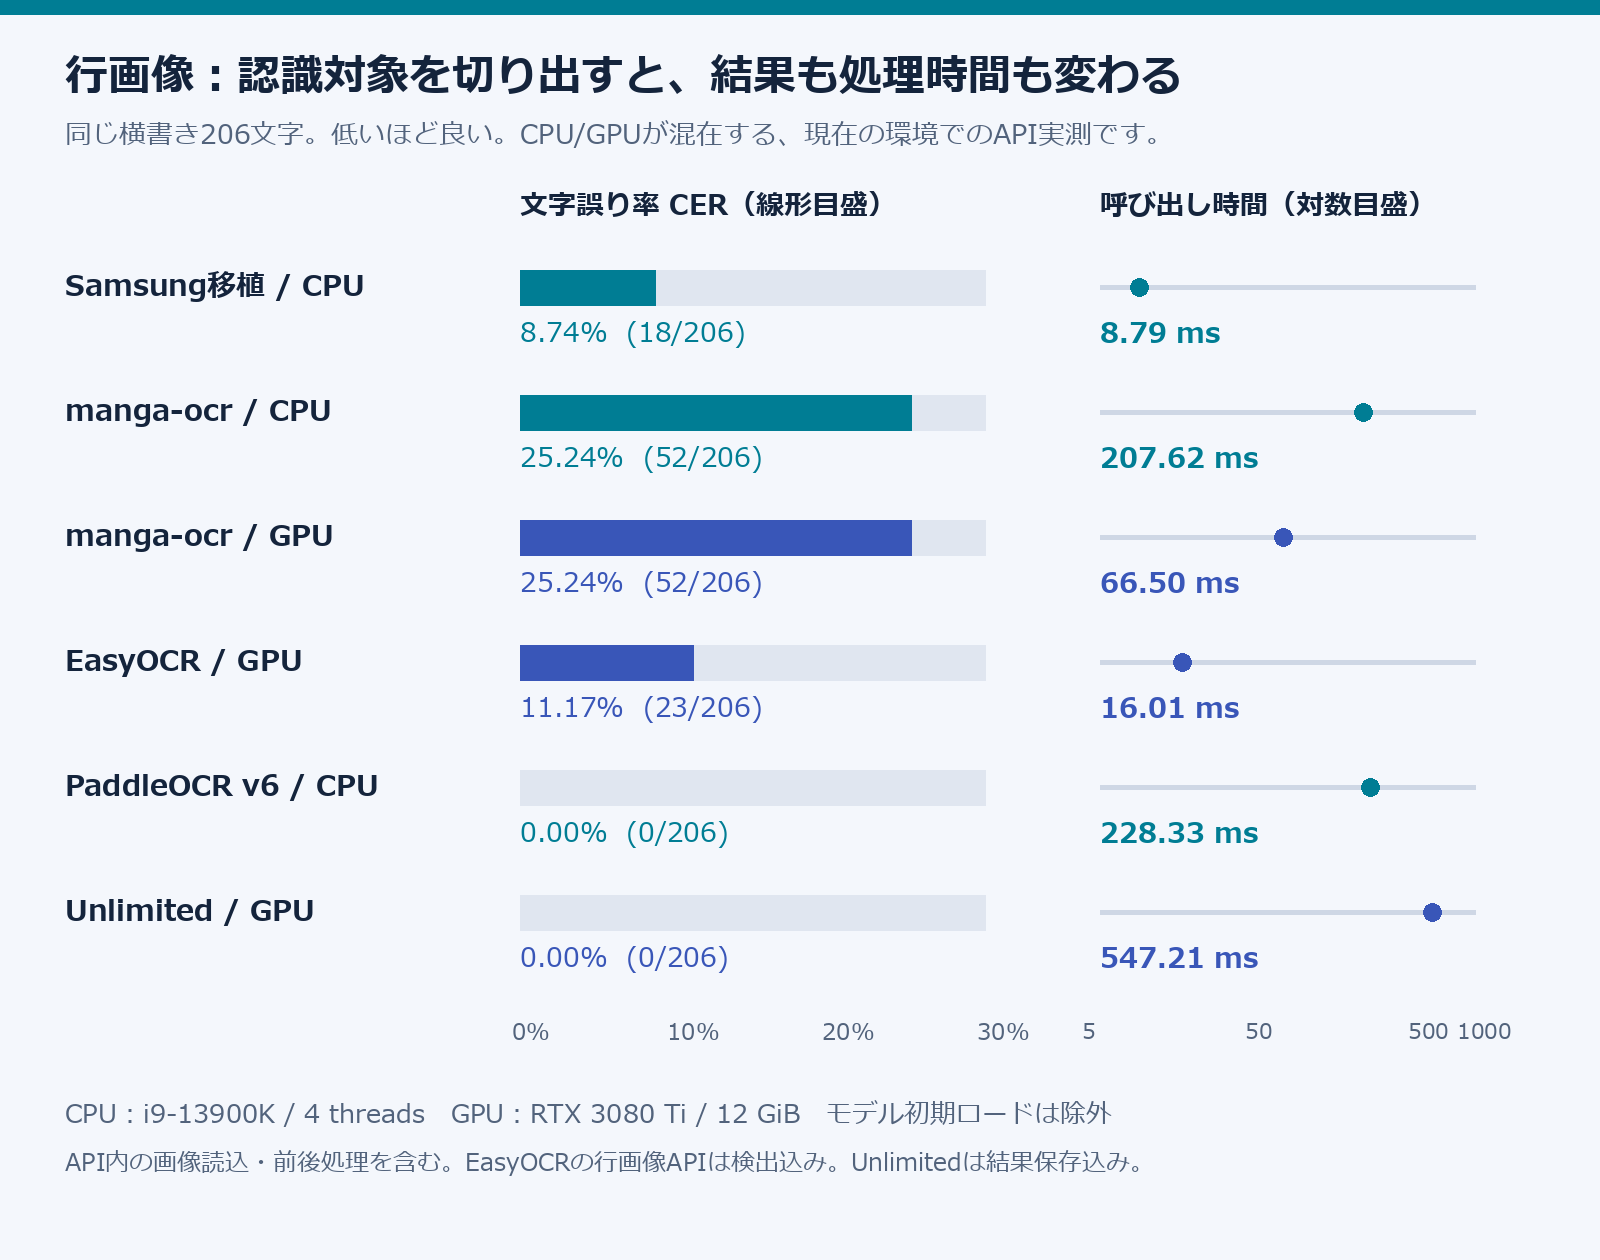
一見すると、検出を省いた方が認識が悪いのは不思議です。しかし11行のうち2枚は7度傾いたままです。Samsungの行認識APIはこの傾きを別途補正せず、ページ側では検出した領域を回転・整形します。余白や切り出しも違います。認識器が同じでも、渡される画素が変われば結果が変わることを示しています。
manga-ocrではCPUとGPUの文字出力は同じで、時間はGPUが短くなりました。今回の英数字混在や低コントラストの長い行では誤りが多くなっています。ただし、漫画に特化したモデルを少量の印刷短文だけで評価した結果です。この25.24%を漫画全般の誤り率として扱うことはできません。
13.縦書きは「字形」「列」「順序」を分けて考える
縦書きは右列「明日の朝は東京駅に集合」、続いて左列「新しい本を読んでいます」の22文字です。Paddleは両列の文字を正しく取りましたが、左列から先に返しました。順序どおりに全文を連結してCERを計算すると22/22=100%になります。列を正しく対応させると文字自体の誤りは0です。
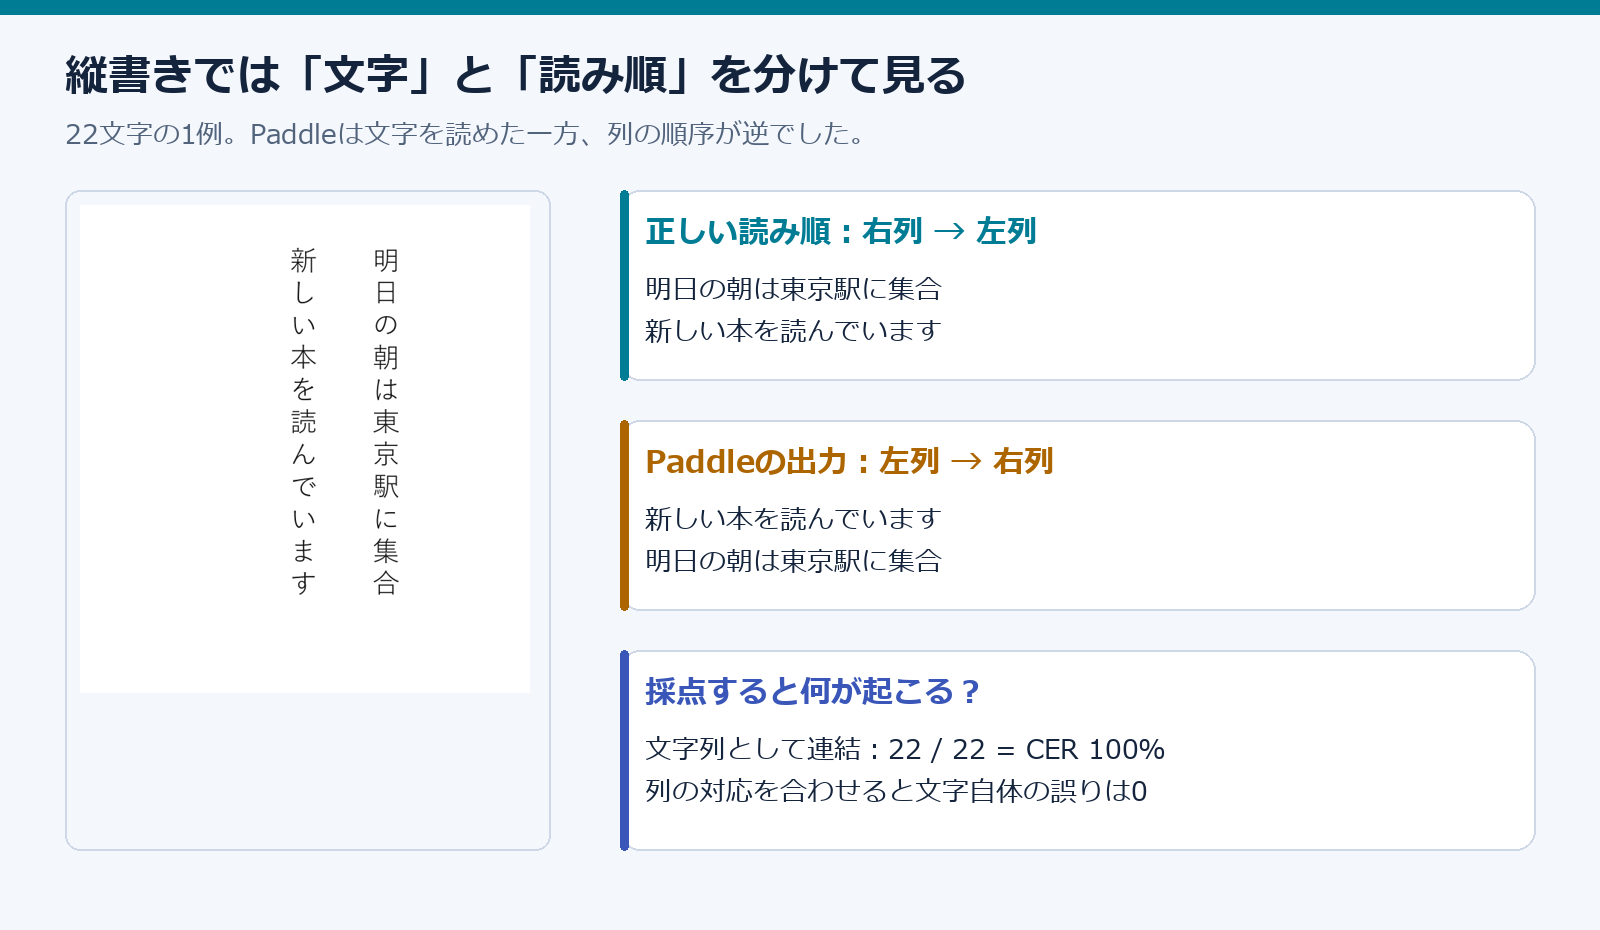
Unlimitedは右列の「明日の朝」を「明日的朝」にする1文字の誤りがあり、左列は1文字ずつ改行されました。空白・改行を除いた順序込みのCERは1/22=4.55%です。改行の多さを別途評価する必要はありますが、そのまま文字誤り数へ加算してはいません。
manga-ocrはこの2列のまとまりを直接渡すと、全文を正しく読みました。一方、各列を別々に渡した場合には余分な文字が出たケースもあります。画像の範囲や文脈の単位が生成結果に影響する例です。縦書き1例だけで一般的な優劣を決めることはできません。
Samsung移植版は横書き向けの行グループ化と認識経路なので、今回の縦書きは正しく扱えませんでした。EasyOCRもこの入力では崩れました。Samsung移植版の制約から、Galaxy純正OCRの縦書き能力を判定することはできません。純正で使われる補助モデルや向きの選択経路を移植していないためです。
14.白紙を読ませると、認識型と生成型の違いが見える
白紙1枚では、Samsung、EasyOCR、Paddleは空文字列を返しました。Unlimitedはという画像ブロックをMarkdownとして出しましたが、文字テキストは空でした。manga-ocrは「そういえば、」と出力しました。
生成型の認識器は、視覚的な根拠が乏しくても言語として自然な続きを出す場合があります。manga-ocrの公式READMEにも、この振る舞いの説明があります。吹き出しを確実に切り出して渡す用途と、ページ中のあらゆる余白を自動投入する用途では、必要な対策が違います。
対策の候補は、前段の文字検出、空白・低情報量の判定、検出器と認識器の信頼度の組み合わせなどです。ただし、単純に画像が明るいかどうかで弾くと、薄い文字も失うおそれがあります。今回の白紙は1枚だけなので、幻覚の発生確率を推定する試験ではありません。モデルの振る舞いを確認した一例として示しています。
15.237万パラメーターでも、必要メモリーが10 MBとは限らない
Samsungの主な検出と日本語認識は合計約236.6万パラメーター相当です。しかし、モデルの重みの容量と、実行時のメモリーは別です。計算中には中間特徴、演算用バッファ、画像、ランタイムの領域なども必要です。
| 部分 | 保存パラメーター相当 | 行列積・畳み込みのMAC | 条件 |
|---|---|---|---|
| 文字領域検出 | 642,577 | 2,326,740,992 | 1024×1024、1画像 |
| 日本語CNN | 1,214,344 | 67,719,040 | 64×256、1窓 |
| 双方向GRU | 222,464 | 7,077,888 | 32位置 |
| 文字分類 | 286,328 | 9,027,584 | 32位置 |
| 日本語認識部合計 | 1,723,136 | 83,824,512 | 1窓相当 |
MACは乗算と累積加算を1組として数えたものです。2 FLOPsと数える慣例なら、おおむね2倍になります。ここではBN、活性化、SEの平均、要素積、Resize、画像整形、復号、メモリー転送を含めていません。長い行や多数の行があれば、認識部は繰り返し使われます。
検出器のfloat32初期化値は約2.58 MBですが、最後の連結特徴[1,16,1024,1024]は、それ一つだけで64 MiBです。64 MiBは実測したプロセスのピークではなく、形状から計算した単一テンソルの容量です。重みが小さいので低メモリーで動く傾向は期待できますが、ファイル容量だけで実行メモリーを見積もることはできません。
GPU側で観測したメモリー
| CUDA実行 | PyTorch allocated peak |
|---|---|
| manga-ocr | 0.445 GiB |
| EasyOCR | 0.699 GiB |
| Unlimited-OCR | 7.672 GiB |
これはPyTorchが割り当てたCUDAメモリーのピークです。予約済み領域、ドライバー、画面表示、他プロセスを含むGPU全体の使用量ではありません。SamsungとPaddleはCPU実行だったので、この表に「0 GiB」として並べていません。CPU側のピークRAMを同じ方法で測ったデータもありません。
16.主経路の外にもモデルがある:attentionを一括りにしない
ba.datには検出器以外のONNXもあります。出力がangleと18クラスのclassになっているものや、4クラスのclass_orderを出すものがありました。角度・方向・順序などに関わる可能性がありますが、ラベルの意味とネイティブ側の選択条件は未確定です。
特にba_4.onnxには列・行の位置埋め込みとQ/K/Vの射影があり、2か所でMatMul→Softmax→MatMulのattentionを確認しました。検出器のLKAが畳み込みによるゲートだからといって、「Samsung OCRにはTransformer的attentionがない」と全体をまとめることはできません。
今回の既定Windows経路は、検出器、CNN、変換したGRU、文字分類器の4つのニューラルモデルファイルを使います。これはSamsung製品全体のニューラルネットワーク数ではありません。補助モデル、モアレ用TFLite、別言語の経路、言語資源などまで含めた全構成は、まだ追跡が必要です。
17.Windows移植はどこまでSamsungの実装を使えているか
今回の移植は、Samsungの実際の検出・日本語認識の重みをONNX Runtimeで計算するものです。AndroidのARM64ライブラリを、そのままWindowsのx64 DLLとして動かしたわけではありません。モデルの数値処理を取り出し、実行環境と前後の処理を組み直しています。
検出入力はRGBを0〜1へ正規化し、白い余白で1024×1024へ合わせます。移植側では確率しきい値0.4、ピーク0.65、最小面積8などを使って連結領域を抽出し、行をまとめ、回転矩形から画像を補正します。認識入力ではグレースケール化、必要に応じた明暗反転、高さ64への調整を行います。これらの値は今回の移植実装の条件です。
未完の部分は、辞書・言語モデルの完全な復号、句読点変換の詳細、補助モデルの呼び出し条件、縦書きの処理、現行純正SDKとの中間テンソル照合などです。純正OCRの全機能や品質を再現したとは言えません。
Galaxyギャラリーへの組み込み:ビルドと実機動作は分ける
別の作業では、SC-52Bファームウェア由来のGalaxy Gallery 13.1.04.3に、このモデル経路を組み込む試作APKを作成しました。Samsung固有のOCR呼び出しをJavaのブリッジに接続し、標準Android向けのONNX Runtimeとモデルを同梱する構成です。arm64向けのAPKを再ビルドし、署名と同梱ファイルを確認しました。
ただし、この段階では端末へインストールしていません。他メーカーの端末で起動、画像表示、OCR、文字選択が動いたことも未確認です。Gallery自体にはOCR以外のSamsungサービス依存もあり、ビルド成功だけで「他機種で動くGalaxyギャラリーが完成した」とは言えません。この記事の性能表は、そのAPKの測定ではなくWindows版の測定です。
18.使い分けを考える:目的から必要な機能を決める
今回の結果から考えると、CPUで小さな横書きOCRや文字領域マスクを使う実験にはSamsung移植版が向いています。印刷された日本語短文の正確さを優先する候補には、今回の横書きで誤り0だったPaddleOCR v6 mediumがあります。ただし現在のCPU設定は速度面の改善余地があります。
文書構造を含む出力が欲しい場合はUnlimited-OCRが候補です。大きなGPUメモリーを使う一方、ページを生成型の文書パーサーとして扱えます。漫画の吹き出しや縦書きのまとまりを切り出して読む用途では、manga-ocrが想定する入力と合います。GPUで検出と認識を素早く回す既存パイプラインには、EasyOCRの使いやすさもあります。
この使い分けは、実測した小規模な入力と各モデルの設計からの判断です。一般的な精度順位ではありません。用途に近い画像で、字形の誤り、読み順、余白での生成、初回ロード、連続処理の時間を別々に見て選ぶことが必要です。
- 入力単位:ページ全体か、1行か、吹き出しか。
- 必要な出力:文字列だけか、位置・読み順・表構造も必要か。
- 間違いの許容:句読点の表記差、固有名詞、白紙の生成をどう扱うか。
- 計算資源:CPUだけか、GPUを使えるか。モデル容量と実行時メモリーは両方を見る。
19.解析・比較を追試するために残したもの
今回の記録には、入力画像とハッシュ、正解文、全123レコードの文字出力と時間、モデルのconfig・形状、全層一覧、重み統計、変換・比較スクリプトを保存しました。失敗した実行のログも残し、採用した実行と区別しています。
記事の補足資料として、採点対象の合成画像、出力・時間のCSV、機械可読な集計、測定方法、主要モデルの層構造をまとめたZIPを用意しました。モデル本体やSamsungのAPK・ネイティブバイナリは、この補足資料には含めていません。
補足資料:合成入力・OCR出力・測定値・層構造をダウンロード
モデルを調べるときの基本手順
- APKやモデルのサイズ、SHA-256、由来のバージョンを記録します。
- ZIP内の配置と、DEX/JNIが参照するリソースを確認します。
- DATのヘッダーと長さを読み、領域境界を検証して切り出します。
- ONNXの入出力、初期化値、接続、演算属性から構造を確認します。
- SBFなどの独自形式は、重み配置とネイティブ計算式を照合します。
- 同じ入力から中間出力を比較し、画像前処理、特徴、リカレント層、復号の順に差を絞ります。
# ONNXの基本情報を読む例。推論は実行しません。
import onnx

model = onnx.load('cnn_original.onnx')
for value in model.graph.input:
    print(value.name, value.type)
for node in model.graph.node:
    print(node.op_type, list(node.input), list(node.output))
for weight in model.graph.initializer:
    print(weight.name, list(weight.dims), weight.data_type)
名前だけではなく、実際のカーネル、stride、接続、定数を見ます。例えばHardSwishが演算子名として保存されていなくても、Add→Clip→Div→Mulという並びと定数から同定できます。逆に、似た形状だけで学習データや蒸留の有無まで推測することはできません。
比較の再集計は、生の出力と時間から行う
補足CSVには各呼び出しの時間と、正規化後の編集距離を残しています。行のCERの単純平均ではなく、誤り数の合計を正解文字数の合計で割ります。時間は各画像の繰り返しの中央値を計算してから、画像間の中央値を取ります。全画像を一つの平均値にすると、短い行と長い行の扱いが変わります。
import statistics

cer = sum(r['normalized_edit_distance'] for r in cases) / sum(
    r['reference_characters'] for r in cases
)
median_ms = 1000 * statistics.median(
    statistics.median(r['repeat_seconds']) for r in cases
)
実行時にはWindows固有の問題もありました。EasyOCRの入力でOpenCVが日本語パスを読めず、PILで開いてNumPy配列を渡すようにしました。PaddleではTorchより先に読み込むと共有DLLの読込に失敗するため、Torch→Paddleの順にし、MKLDNNを無効にして実行できました。この環境での「Paddleが動かない」という初回結果を、そのまま性能表に残してはいません。
20.分かったことと、まだ分からないこと
今回、APKに含まれる日本語DATからCNN、双方向GRUv2、文字分類器、文字表を取り出し、検出器を含む重みの出典を照合できました。ネットワークの形状、ゲート順序、保存初期状態、非対称stride、SE、LKA、FPN、補助attentionまで具体的に確認しています。Windowsで実際に読み、他のインストール済みOCRとの違いも観測できました。
未確定なのは、学習データ、学習時の損失、蒸留や事前学習の有無、純正の長い行の扱い、言語資源の全形式、補助モデルの選択条件、現行Galaxy上の中間テンソルとの一致です。Windows移植の縦書き対応と、他メーカー端末での改変Galleryの動作も残っています。
OCRはモデル名やパラメーター数だけで理解できるものではありません。画像から文字領域を探し、読みやすく整形し、特徴の列を文字列へ変え、必要なら言語やレイアウトの情報で整える。その各工程を分けて見ると、小さなモデルが速く動く理由も、大きな生成モデルが構造を扱える理由も、失敗がどの工程で生まれるかも追いやすくなります。
今回のSamsung OCRは、モバイル向けの小さな認識器を具体的に学ぶ材料になりました。同時に、移植で失われた処理が結果に表れることで、純正SDKの前後処理や復号まで理解する重要性も分かります。次に必要なのは、現行ネイティブ版との段階ごとの数値照合と、実際の用途に近い画像での評価です。
参照資料と証拠の範囲
層数、形状、重みの数、測定値は今回のローカル実体と実行ログから作成しました。以下の一次資料は、製品説明、モデル系列、演算仕様、公開モデルの用途を確認するために参照しています。公開論文のモデルが、そのまま今回のSamsung APKに入っていると断定する根拠には使っていません。
- Samsung Research:One UIの文字・画像認識技術 — 端末内動作、言語判別、認識、言語モデルの説明。
- Visual Attention Network公式実装 — LKA構造の比較。
- Searching for MobileNetV3 — bottleneck、SE、活性化の比較。
- ONNX GRU仕様 — ゲート順序とlinear_before_reset。
- manga-ocr公式 — 入力の想定、複数行・縦書き、白紙での生成。
- EasyOCR公式モデル実装 — VGGと双方向LSTMの認識経路。
- PaddlePaddle:PP-OCRv6 medium認識モデル — 今回の保存モデルに対応する説明。
- Baidu Unlimited-OCR公式/Unlimited OCR Works — 推論設定とR-SWA。
- 参照した旧世代Samsungネイティブライブラリの公開ダンプ — 固定コミット。対象APKとは世代が異なります。
記事中の「誤り0」は今回の採点画像に対する結果です。一般の文書での完全な認識、Galaxy製品版との同等性、改変APKの他機種動作を保証する表現ではありません。主な図は解析・測定値から作図し、ヒーロー画像のみAI生成です。